OpenAI wprowadza ukryte znakowanie tekstów generowanych przez ChatGPT
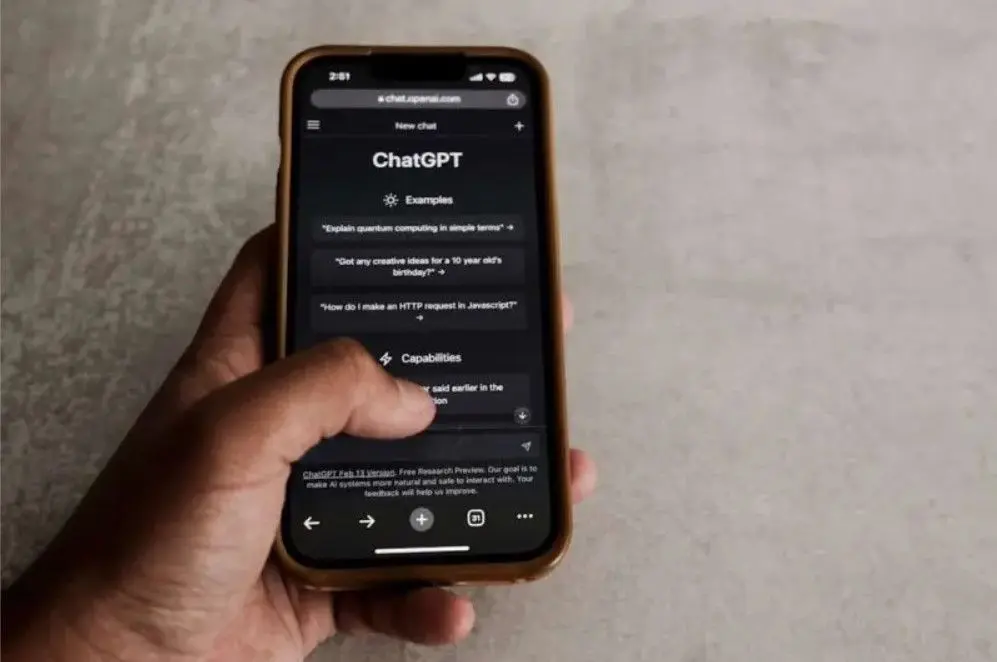
W tekstach generowanych przez ChatGPT i Codex pojawią się niewidzialne znaki wodne. Rozwiązanie ma pomóc w identyfikacji treści tworzonych przez AI.

SOFT-IB Centrum Kas Fiskalnych
Centrum Kas Fiskalnych. Sprzedaż i serwis: kasy fiskalne, terminale płatnicze, oprogramowanie dla firm, komputery
OpenAI uruchamia w Unii Europejskiej system ukrytego znakowania treści generowanych przez ChatGPT i narzędzie programistyczne Codex. W praktyce ma to ułatwić odróżnienie tekstu tworzonego przez model od materiału przygotowanego przez człowieka, choć sama technologia ma wyraźne ograniczenia.
Zmiana dotyczy wszystkich planów abonamentowych dla użytkowników w UE. W przypadku API znak wodny będzie dostępny jako opcja opt-in, czyli domyślnie pozostanie wyłączony. To kolejny krok po ruchu Anthropic, które dwa miesiące wcześniej zaczęło znakować teksty modelu Claude, przy czym tamto wdrożenie objęło cały świat, a nie tylko rynek unijny.
Jak działa ukryty ślad w tekście
W przeciwieństwie do zdjęć czy banknotów zwykły tekst nie daje się oznaczyć prostą pieczęcią ani widocznym logo. Dlatego OpenAI sięga po system textGrain, który działa na poziomie wyboru tokenów, czyli kolejnych słów lub ich fragmentów.
Mechanizm opiera się na tajnym kluczu kryptograficznym i wcześniejszym kontekście wypowiedzi. Model dzieli potencjalne słowa na dwie grupy, umownie zieloną i czerwoną, a następnie lekko faworyzuje te z grupy uprzywilejowanej, jeśli nie psuje to sensu ani płynności tekstu. Dla czytelnika rezultat wygląda normalnie, ale odpowiedni detektor potrafi wykryć statystyczny wzór wskazujący na ingerencję algorytmu.
Kiedy sygnatura przestaje działać
OpenAI przyznaje, że znak wodny nie jest nieusuwalny. Nie da się też na jego podstawie automatycznie stwierdzić, że brak sygnatury oznacza autora człowieka. System traci skuteczność w kilku sytuacjach:
-
przy zbyt krótkim tekście, bo do wiarygodnej analizy potrzeba odpowiednio długiej próbki,
-
po parafrazie lub redakcji wykonanej przez człowieka, która rozbija wcześniejszy układ prawdopodobieństw,
-
po przepuszczeniu odpowiedzi przez inny model, na przykład open-source, z prośbą o przeredagowanie własnymi słowami.
Właśnie dlatego firma nie udostępnia publicznego detektora. Jak przekazała w oficjalnym komunikacie, dostęp do narzędzia dostaną na razie tylko zatwierdzeni badacze i organizacje eksperckie, które mają pomóc ocenić jego wiarygodność i odpowiedzialne zastosowania.
Obawy przed fałszywymi oskarżeniami
OpenAI obawia się przede wszystkim błędnych wskazań w szkołach i urzędach, ale także tego, że powszechny dostęp do detektora ułatwiłby tworzenie narzędzi do usuwania sygnatury, czyli tzw. spoofingu. Firma podkreśla też, że sam znacznik nie pokazuje, ile w danym tekście było ludzkiej pracy, korekty czy twórczej decyzji.
To ważny spór, bo użytkownicy od dawna zwracają uwagę, że w wielu przypadkach to oni przygotowują kontekst, strukturę i treść polecenia, a model jedynie wykonuje zadanie. Krytyka pojawiła się również wtedy, gdy Anthropic wprowadził podobne oznaczanie w Claude.
Problem wynika z wymogu zawartego w unijnym Akcie o sztucznej inteligencji. Artykuł 50 nakłada na dostawców systemów AI obowiązek oznaczania treści syntetycznych w sposób możliwy do odczytania maszynowo. W praktyce tekst okazuje się jednak znacznie trudniejszy do jednoznacznego oznaczenia niż obraz czy wideo, gdzie metadane C2PA dają stabilniejszą podstawę do weryfikacji.
OpenAI zaznacza, że nowe rozwiązanie może wskazać, iż system firmy wygenerował lub przetworzył fragment tekstu, ale nie rozstrzyga, jak duży był udział człowieka. Właśnie dlatego granica między autorstwem ludzkim a maszynowym pozostaje dziś nieostra, mimo że Unia próbuje ją uporządkować przepisami.
Czytaj także: Polacy chcą danych o wpływie AI na środowisko
Źródło: MamStartup Fot. Pexels
Autor:KP